SELF-PACED WORKSHOP
让行走技能适应坡地
用 Isaac Sim 构建可控的坡道,在 Isaac Lab 中测试现有策略,再用多种地形训练并比较结果。
先提出可检验的问题
本章不预设“旧模型一定会摔倒”。任务是从平地出发,走上或走下一段坡道,抵达另一端并保持平衡。先固定模型、速度、时长、摩擦和起点扰动,只改变坡度。这样才能判断性能变化来自地形,而不是换了几项设置。
左右滑动查看完整图示
搭建平地—坡道—平台场景
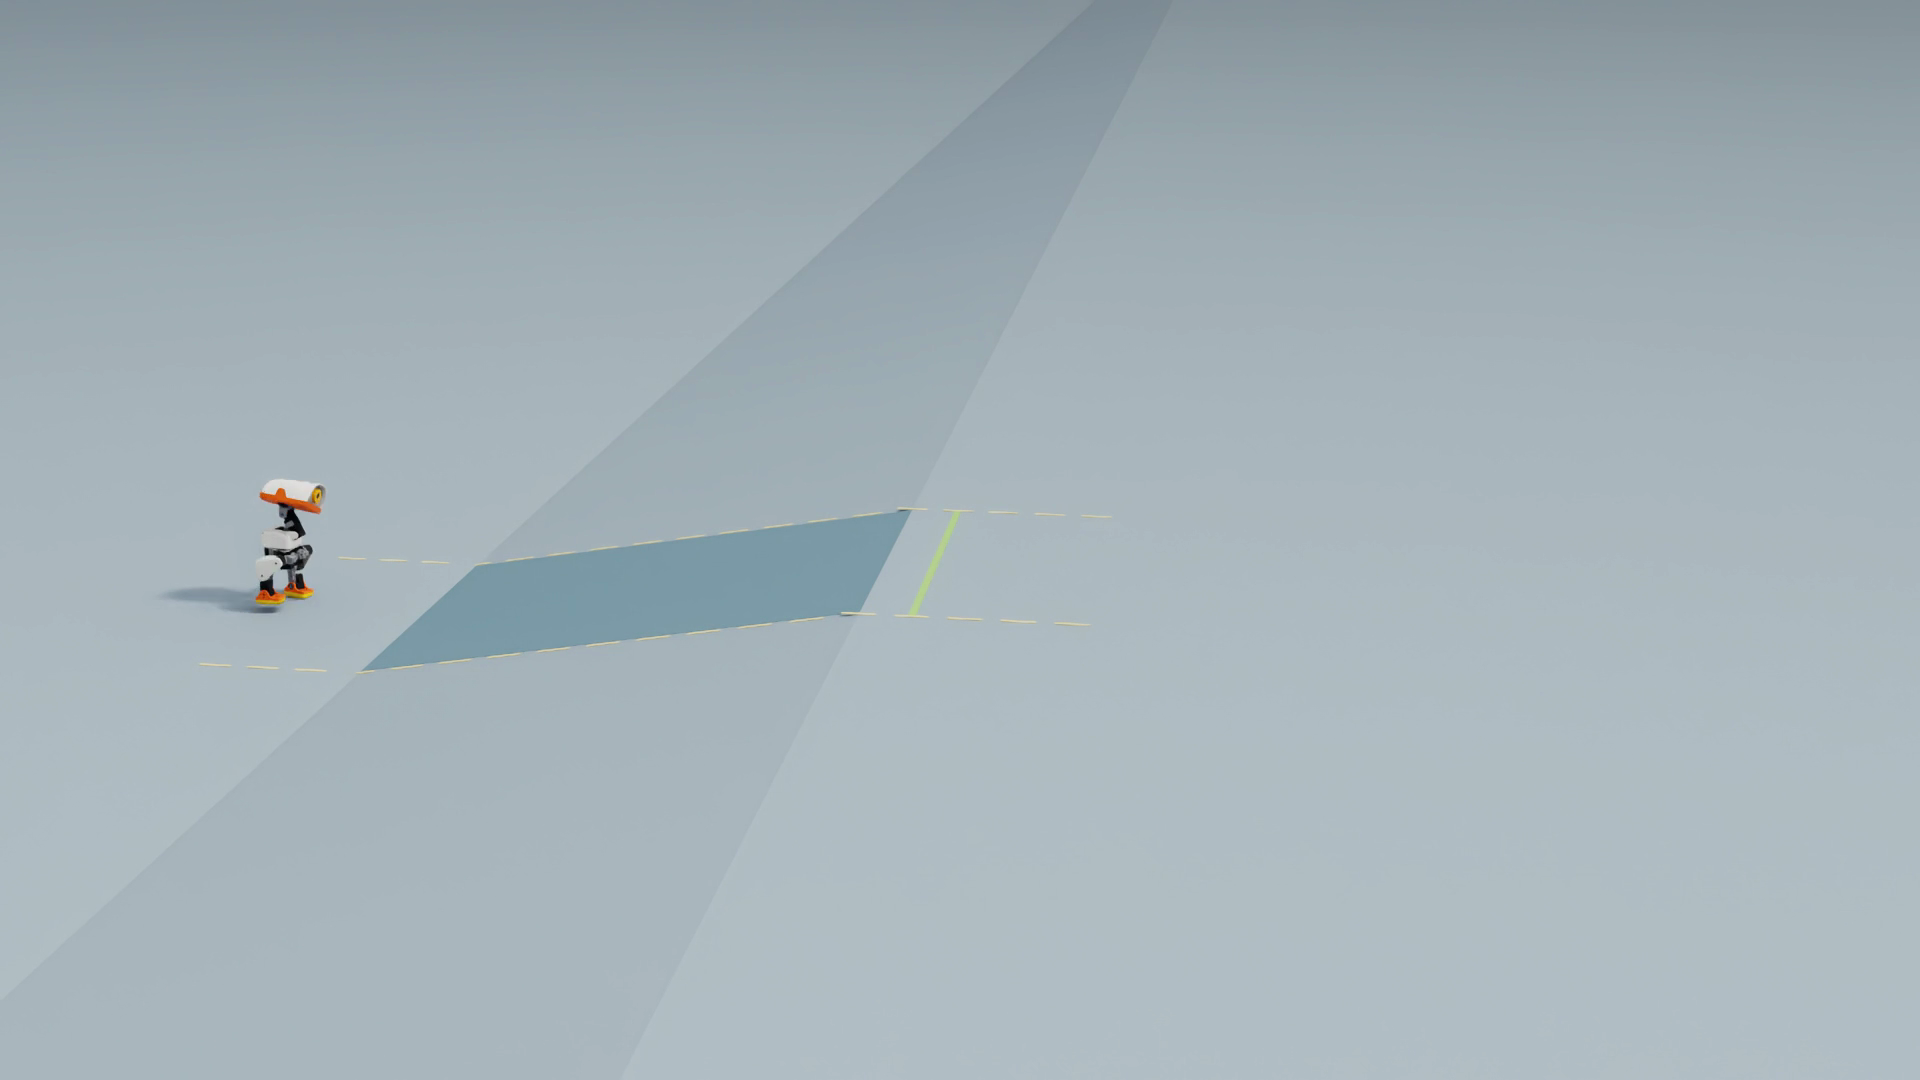
评测场景由三段连续表面组成:出发后 0.35 m 为平地,接着是水平长度 1 m 的坡道,最后是落脚平台。正角度表示上坡,负角度表示下坡。用一个连续碰撞网格连接它们,避免装饰性台阶意外改变实验。视觉材质与灯光用于辨认坡面;质量、摩擦和碰撞几何才决定接触运动。
slope = math.tan(math.radians(cfg.slope_deg))
xs = [-48.0, 2.35, 3.35, 52.0]
zs = [0.0, 0.0, slope, slope]
vertices = [(x, y, z) for x, z in zip(xs, zs) for y in [-48.0, 52.0]]
origin = np.array([2.0, 2.0, 0.0])
网格坐标的起点为 (2, 2, 0);减去这个原点后,机器人相对起点为 x = 0,坡道从 x = 0.35 m 延伸到 1.35 m。前后的支撑面总计扩展到 100 × 100 m,避免失败后从小块地形边缘掉落。Isaac Lab 的 TerrainGenerator 和 TerrainImporter 让同一几何用于可视化、物理测试与并行训练。
先测官方行走策略
先让官方行走策略在 5° 上坡运行 20 秒。在课程仓库根目录打开终端,运行下面的命令;输出目录应使用尚不存在的新名称。
python3 scripts/workshop.py terrain \
  --model models/walk.onnx \
  --slope 5 --num-envs 1 --seconds 20 --seed 42001 \
  --output outputs/slope-up-05
不加 --headless 会打开 Isaac Sim。批量评测时使用 --num-envs 5 --headless;将坡度依次改为 0、5、−5、10、−10、15、−15,并给每次运行使用新的输出目录。前 2 秒站立,随后给出 0.25 m/s 前进指令;实际速度由策略和物理系统共同决定,并不保证等于指令。
达到目标须在 20 秒内走到 x ≥ 1.45 m,抵达时横向偏移小于 0.3 m,并且整段实验不跌倒。跌倒后不自动重置;机器人即使随后滑过终点,也不计为成功。报告分别保存到达情况、跌倒情况和速度均方根误差。
| 坡度 | 到达且全程未跌倒 | 跌倒 |
|---|---|---|
| 0° | 5/5 | 0/5 |
| +5° | 0/5 | 0/5 |
| -5° | 0/5 | 5/5 |
| +10° | 0/5 | 0/5 |
| -10° | 0/5 | 5/5 |
| +15° | 0/5 | 0/5 |
| -15° | 0/5 | 5/5 |
这组基线每个坡度使用 5 个起点轻微扰动的环境。平地 5/5 通过;上坡没有跌倒,但停滞在坡道中;下坡 5/5 跌倒。它说明当前模型需要适应这些地形,但样本数较小,不应据此推断任意坡地的可靠性。
为什么平地经验不能直接覆盖坡地
坡面改变了脚与地面的相对高度、重力沿坡方向的分量和可用摩擦。上坡时,抬脚和推进不足可能让机器人停在坡上;下坡时,重心向前移动与落脚高度变化可能让机器人来不及恢复平衡。仅看“是否摔倒”会漏掉上坡停滞,因此到达率与速度误差也很重要。
Newton 会在每个物理步计算重力、接触和执行器响应;Isaac Lab 则让同一策略在多种坡度上反复试验。我们不必手写一套上坡步态,但需要让训练场景和奖励覆盖这些变化。
拓展:坡度怎样改变重力与摩擦
把重力沿坡面和垂直坡面两个方向分解,就能理解为什么上坡需要更多推进、下坡更需要控制速度。这里把机器人暂时看作坡面上的一个物体,用准静态近似说明趋势。
m 是质量,g 是重力加速度,α 在这里取坡面与水平面的夹角大小;前面测试中的正负号只用来区分上坡和下坡。沿坡向下的分量 mg sin α 会阻碍上坡、促进下坡;垂直坡面的分量 mg cos α 决定近似支持力 N。α = 0 时,沿坡分量为零;坡越陡,这个分量越大。
μ 是摩擦系数,F_tangent 是接触面所需的切向力。要保持不滑动,所需切向力的大小不能超过 μN。以 10° 坡道为例,沿坡重力约为重量的 17%,支持力约为重量的 98%;这些比例说明受力趋势,不能直接变成策略的最大坡度。
这个近似忽略了迈步加速、单脚支撑和足底碰撞。实际行走时支持力会变化,Newton 会逐步求解相应动力学。判断策略是否适用,仍要同时检查到达、跌倒和速度误差。
在多种地形中继续学习
保留官方 ONNX,复制其网络权重与归一化参数作为新策略的起点。训练使用 25% 平地、其余为不同坡度的上坡和下坡地形;环境并行收集不同状态下的经验。新价值网络与优化器单独初始化。训练前先检查新策略网络与原 ONNX 对同一观测的输出一致,避免接口错误被误认为“需要更多训练”。
python3 scripts/workshop.py train-terrain \
  --model models/walk.onnx \
  --num-envs 256 --iterations 1000 --seed 43001 \
  --output outputs/terrain-training-01
这里的坡度参数是 tan(α),不是角度值;范围 0.03–0.22 对应约 1.7°–12.4°。训练地形使用金字塔坡面与反向坡面,评测保留直线坡道,因此不是在训练场景原位重复演示。训练和评测随机种子也分开。
sub_terrains = {
    "flat": MeshPlaneTerrainCfg(proportion=0.25),
    "slopes": HfPyramidSlopedTerrainCfg(
        proportion=0.375, slope_range=(0.03, 0.22), platform_width=0.7
    ),
    "descending": HfInvertedPyramidSlopedTerrainCfg(
        proportion=0.375, slope_range=(0.03, 0.22), platform_width=0.7
    ),
}
本节固定坡地权重保留原训练结果。当前训练入口使用与演示一致的全身碰撞资产,因此新练习的接触配置与历史训练不同,输出属于新实验。训练本身不渲染画面;完成后用统一 RTX 场景检查导出的策略。
不仅要站稳,还要走向目标
在坡道上,站稳只是第一步。机器人还要朝目标方向走:即使一直迈步,只要出现持续的小幅转向,走过一段距离后也会偏离落脚平台。前进速度奖励主要约束机身坐标系下的速度,身体转偏后仍可能“向自己的前方走得很好”,因此需要单独检查转向速度。
先把期望行为写清楚:指令要求直行时,绕身体 z 轴的角速度应接近零;指令要求转弯时,实际角速度应接近指令。这里约束的是转向速度,不是身体始终朝向某个固定世界方向;它也不能直接修正已经积累的航向误差。坡面上身体 z 轴与世界竖直方向不完全重合,这仍是一个局部控制指标。
ωz 是机身坐标系中绕 z 轴的角速度,训练时从仿真状态读取;ωz* 是转向指令,单位都是 rad/s。误差可以为正也可以为负,两边都需要惩罚,所以用平方;再除以容忍尺度 σ,把不同量级的误差变为无量纲数。这里取 σ = 0.15 rad/s,表示我们希望重点区分这一量级附近的转向误差。
误差为零时奖励为 1;误差增大时奖励平滑降向 0,而且左右转偏受到同样的影响。这个指数形式是便于优化的一种设计选择,不是由物理定律唯一推出的公式。σ 太小,大多数动作都只能得到接近零的奖励;σ 太大,又难以区分方向保持得好不好。
| 转向误差的大小 | 原始奖励 rω | 如何理解 |
|---|---|---|
| 0 rad/s | 1.000 | 完全跟随转向指令 |
| 0.075 rad/s(0.5σ) | 0.779 | 小幅偏差仍有较高奖励 |
| 0.15 rad/s(1σ) | 0.368 | 误差达到容忍尺度,奖励明显降低 |
| 0.30 rad/s(2σ) | 0.018 | 偏差较大,几乎得不到这一项奖励 |
def yaw_rate_tracking(env, std=0.15):
    # Match the commanded turn rate without penalizing normal roll/pitch motion.
    velocity = env.scene["robot"].data.root_link_ang_vel_b.torch
    target = env.command_manager.get_command("base_velocity")[:, 2]

    # Squared, normalized error gives a symmetric reward in (0, 1].
    return torch.exp(-((velocity[:, 2] - target) / std).square())


cfg.rewards.yaw_precision = RewardTermCfg(
    func=yaw_rate_tracking, weight=4.0, params={"std": 0.15}
)
代码取出所有并行环境的机身角速度和转向指令,按环境逐项计算上式。weight = 4 把原始奖励乘以 4,再交给 Isaac Lab 的奖励管理器与其他项组合;管理器还按策略步长统一缩放。它表示相对重视程度,不是“成功率提高 4 倍”。姿态、动作平滑和前进速度项仍然保留,防止策略只顾停止转动而不走路。
为什么单独取 z 分量?行走本身伴随横滚和俯仰角速度。如果把三轴误差一起放进过窄的奖励范围,正常步态的晃动也可能压低得分。单独的 z 轴项让转向反馈更明确,同时继续用其他奖励约束身体稳定。
python3 scripts/workshop.py train-terrain \
  --model models/walk.onnx \
  --resume outputs/terrain-training-01/model_999.pt \
  --refine-heading --num-envs 256 --iterations 1500 --seed 43002 \
  --output outputs/terrain-heading-01

python3 scripts/workshop.py train-terrain \
  --model models/walk.onnx \
  --resume outputs/terrain-heading-01/model_2498.pt \
  --refine-heading --yaw-precision \
  --num-envs 256 --iterations 2000 --seed 43003 \
  --output outputs/terrain-direction-01
第一条命令继续训练并加强原有角速度跟踪,同时固定名义物理参数。第二条增加独立的 z 轴转向奖励,也调整了原角速度项和线速度项的权重。每一步都从已有检查点继续,原官方模型保留;改变训练轮数后,请以实际保存的检查点文件名为准。
怎样验证它是否有用?先在 TensorBoard 看这一项的平均奖励,再用相同坡度、相同速度指令和独立种子比较实际角速度误差、横向偏移、到达率与跌倒率。奖励提高而机器人不前进,或走得更直却频繁摔倒,都不能算改进。奖励是训练信号,任务条件才是最后的验收标准。
已有实验提供了什么证据?前一阶段的策略在 +5° 开发测试中走上坡道,却因横向偏离而未通过到达条件;后续策略在相同开发坡度上达到 5/5,固定模型后的独立评测也在 +5° 达到 5/5。不过,后续阶段还改变了其他奖励设置并增加了训练轮数,因此这组结果只能说明整套调整有效,不能单独证明转向奖励的因果贡献。
拓展:设计一个只检验转向奖励的消融实验
从同一个检查点复制两份训练,保持地形、指令分布、其他奖励、优化器、训练步数和种子配对一致。实验组启用 z 轴转向奖励,对照组只把这一项权重设为零;用多个训练种子重复。这样比较的才是这一项奖励带来的差异。
训练后冻结两个候选策略,用未参与调参的相同评测种子逐对测试。预先约定比较转向速度误差、横向偏移、到达率和跌倒率,并报告所有结果。如果转向误差下降且到达率提高,同时没有增加跌倒,才有更充分的证据支持这个设计。这里提供的是可选实验设计,尚未完成这组独立消融。
用同一把尺子比较新旧策略
python3 scripts/workshop.py terrain \
  --model models/terrain-walk.onnx \
  --slope 5 --num-envs 5 --seconds 20 --seed 49001 --headless \
  --output outputs/terrain-evaluation-up-05
默认使用已训练好的 models/terrain-walk.onnx,大小约 0.79 MB;想评估自己的模型时,将路径显式改为 outputs/terrain-direction-01/exported/policy.onnx。这个坡地模型只用于本章,第一章与第六章仍使用原行走策略。
对官方模型和新模型使用相同的评测种子与坡度表。至少同时报告平地、上坡和下坡的通过数、跌倒数、速度误差及训练耗时。没有跌倒但停在坡上,属于未完成任务;坡地改善却丢失平地能力,也不算合格替代。学生训练出的模型只有经过这样的验证,才适合显式替换默认策略。
| 坡度 | 官方策略通过 | 坡地策略通过 | 坡地策略跌倒 | 坡地策略速度 RMSE |
|---|---|---|---|---|
| 0° | 5/5 | 5/5 | 0/5 | 0.094 m/s |
| +5° | 0/5 | 5/5 | 0/5 | 0.105 m/s |
| -5° | 0/5 | 5/5 | 0/5 | 0.089 m/s |
| +10° | 0/5 | 5/5 | 0/5 | 0.122 m/s |
| -10° | 0/5 | 2/5 | 0/5 | 0.090 m/s |
| +15° | 0/5 | 0/5 | 5/5 | 0.210 m/s |
| -15° | 0/5 | 0/5 | 5/5 | 0.179 m/s |
表中每个坡度各运行 5 个环境,使用未参与模型训练与选型的固定评测种子 49001,两种策略均使用官方全身碰撞模型。支撑面修正时复用了同一种子,不计作额外独立样本。通过要求与前面完全相同;表中的速度 RMSE 是五个环境的均值,每个环境仅统计首次跌倒前、开始前进后的采样,避免跌落后的运动混入行走误差。到达时横向偏移小于 0.3 m,不等于全程严格沿直线行走。样本较少,这些结果不能推广为任意坡地的成功率。完整条件与逐环境结果见评测数据。
坡地策略在平地、±5°和上坡 10°保持较好的通过表现;下坡 10°虽然五次都没有跌倒,但三次偏离到达区域,±15°则全部跌倒。这说明稳定性、行走方向和任务完成是不同指标。每个坡度仅五次,不能把结果差异全部归因于某个参数。先检查失败轨迹,再决定是否增加训练难度或调整奖励;行走接口相同,也不意味着这份坡地策略已经适配自主射门的接近与出脚切换。
检查理解
为什么评测坡道不应和训练地形完全相同?
查看解析
目的是检验学到的能力能否适应新的起点与几何,而不仅是在熟悉的布局里重复动作。两种模型应共享评测条件,且评测结果不能反过来当作独立测试仍未见过的数据。
同一条坡道,再试轮滑模式
四个轮子会改变支撑与阻力。上坡时必须通过腿部动作持续提供推进,下坡时松开指令仍可能加速;不能把平地轮滑直接当成坡地技能。这里沿用相同坡面、连续支撑地面、20 秒时限、到达位置与不跌倒标准,另列轮滑结果。推进命令与行走的速度命令语义不同,因此不比较两者的速度跟踪误差。
下面的命令在 +5° 坡道上运行 5 个轮滑副本。先看终端结果中的 passed 与 fell;需要录像时改为一个环境并增加 --record,为每次运行换一个输出目录。
python3 scripts/workshop.py terrain \
  --locomotion rollers \
  --model models/official-browser/rollers.onnx \
  --slope 5 --seconds 20 --num-envs 5 \
  --seed 55011 \
  --output outputs/rollers-slope-01
进一步试 −5°、+10° 和 −10°。记录“是否到达”和“整段是否跌倒”两个不同结果:下坡滑过终点后摔倒仍不算通过。这里没有换用专门训练的坡地轮滑模型,失败也是这项迁移实验的有效结果。
| 坡度 | 完整通过 | 整段未跌倒 |
|---|---|---|
| 0° | 5/5 | 5/5 |
| 5° | 0/5 | 5/5 |
| -5° | 0/5 | 0/5 |
| 10° | 0/5 | 3/5 |
| -10° | 0/5 | 0/5 |
这组固定官方轮滑策略在平地通过 5/5;+5° 上坡虽然全部保持直立,却明显横向偏离,未满足规定的到达位置。它尚不能直接替代坡地行走策略。种子 55011 在轮胎接触修正时复用,属于固定配置核查,不是新增的独立泛化样本;它与前表步行实验的种子也不同。完整记录见轮滑坡地结果。
同一套平台,还能学会什么
您已经用 Isaac Sim 改变了任务环境,用 Isaac Lab 继续训练,并通过统一评测检验了技能的适用范围。下一章看看社区如何用不同任务、观测与奖励,让 Microduck 学会跳跃和平衡等动作。